pedro/projetos/quicksort-paa
Estudo comparativo de Quicksort
Três versões do Quicksort em C++17 medidas em cinco massas de teste, de mil a 500 mil elementos: híbridas até 54% mais rápidas e o pior caso teórico confirmado na prática.
Contexto
Trabalho prático de Projeto e Análise de Algoritmos na PUC Minas, feito em trio com o Marcus e o Gabriel. A partir de um exercício do livro do Ziviani, a proposta era comparar na prática três versões do Quicksort e confrontar os números com a teoria.
Problema
A análise assintótica conta comparações e trocas. A pergunta era se essa contagem ainda explica o tempo de execução num processador atual e qual é, de fato, o melhor ponto para trocar o Quicksort pelo Insertion Sort em subvetores pequenos.
Abordagem
As três versões foram escritas em C++17 sobre um único motor parametrizado, para que todas contassem comparações e trocas exatamente da mesma forma:
- Recursiva clássica, que particiona até subvetores unitários;
- Híbrida, que interrompe a partição abaixo de M elementos e termina com Insertion Sort;
- Híbrida com mediana-de-três, igual à anterior, com o pivô escolhido entre o primeiro, o do meio e o último elemento.
Cada versão rodou sobre cinco massas de teste (aleatória, ordenada, inversamente ordenada, com muitos repetidos e quase ordenada) em quatro tamanhos, de mil a 500 mil elementos, medindo tempo, comparações e trocas. Tudo é reproduzível com make tudo ou com os containers Docker, que também geram os gráficos e compilam o relatório em LaTeX.
Resultados
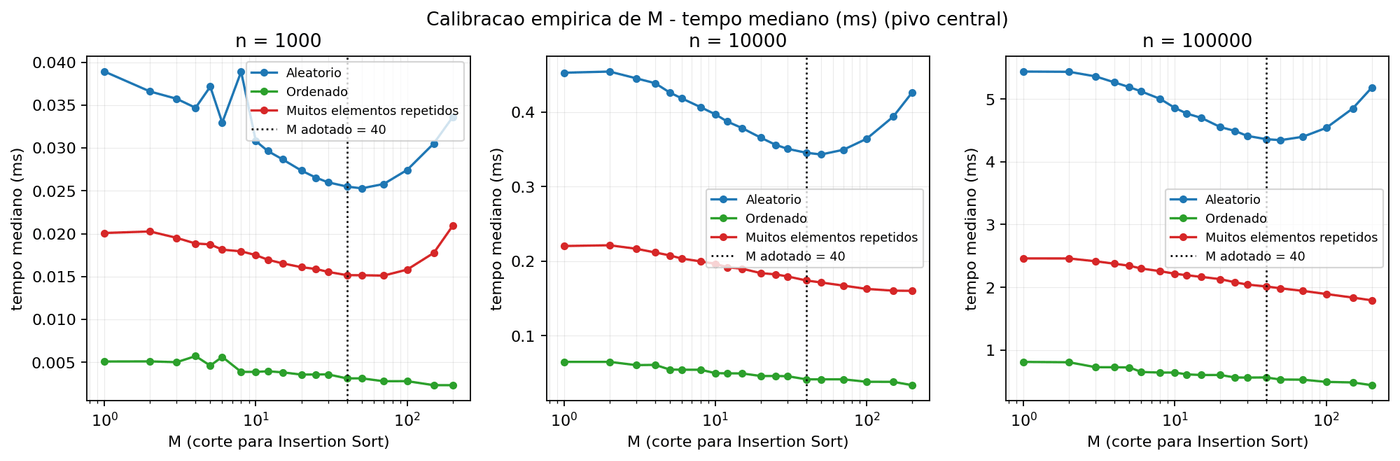
- Ponto de corte M = 40. O mínimo de comparações é estável em M ≈ 20–25, mas o tempo é ruidoso; pelo critério do menor M a até 2% do melhor tempo, o valor ficou acima da faixa de 5 a 25 da literatura clássica. A explicação está no hardware atual: cache e predição de desvios favorecem o Insertion Sort por mais tempo.
- Híbridas de 16% a 54% mais rápidas que a recursiva pura (mediana de 28%), sem perder em nenhuma configuração.
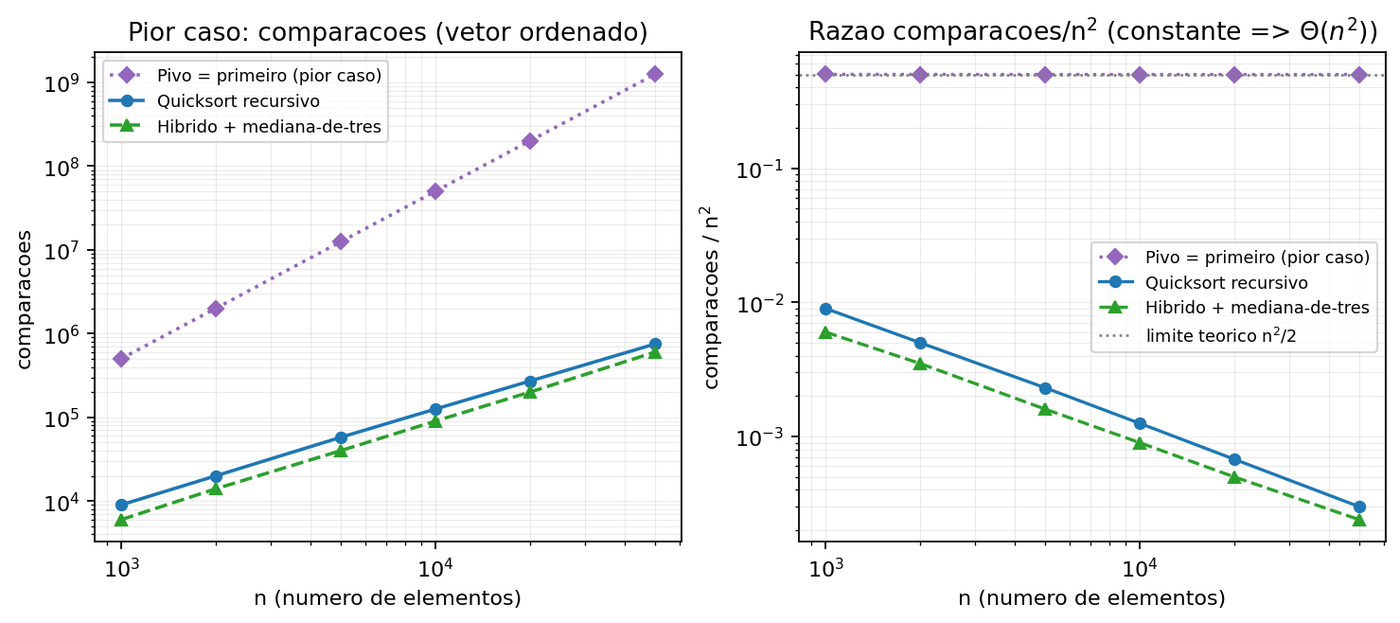
- Pior caso confirmado: com vetor ordenado e pivô no primeiro elemento, a razão comparações/n² convergiu para exatamente 0,5000, as n(n − 1)/2 comparações da teoria. Para n = 50 mil, a diferença para um bom pivô chegou a ~2.000 vezes em comparações e ~1.200 vezes em tempo.
O que mais chamou atenção
Em dados aleatórios, a versão híbrida faz mais comparações e trocas que a recursiva e, mesmo assim, é sempre mais rápida. A contagem de operações continua certa para a análise assintótica, mas deixou de prever o tempo real: cache e predição de desvios pesam tanto quanto o número de operações.
A mediana-de-três também surpreendeu: com o mesmo M, ela só reduz comparações em dados aleatórios (2% a 9%) e fica cerca de 1% pior em entradas ordenadas. O valor dela está na proteção contra pivôs ruins, onde a diferença é de três ordens de grandeza.